Statistiques bi variées - Regression
1 Données d’exemple
On travaille à présent sur un croisement
d’un agrégat financier (frais du personnel)
d’un résultat électoral (la gauche, la droite, etc…)
La donnée est fournie pour le cours par département (voir le moodle)
Enoncer les hypothèses possibles de la comparaison, attention variable explicative (X) et à expliquer (Y)
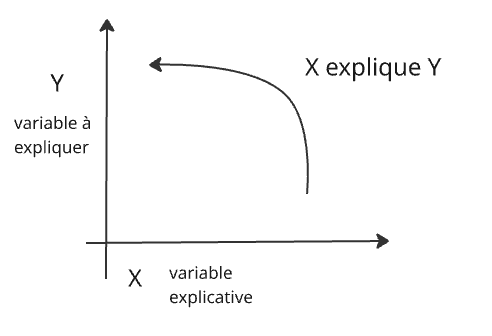
Pour le cours, le vote pour la gauche (X) amène la non maîtrise des frais de personnel (Y)
Pour mémoire, l’hypothèse nulle (H0) est l’absence de relation entre vote pour la gauche et frais de personnel.
data <- read.csv("data/baseCours3_93.csv", fileEncoding = "UTF-8", dec =".")
# Quelle est la nuance majoritaire dans le dpt en 2020 ?
table(data$bloc)
##
## AUT CENT DTE EXD EXG GAU
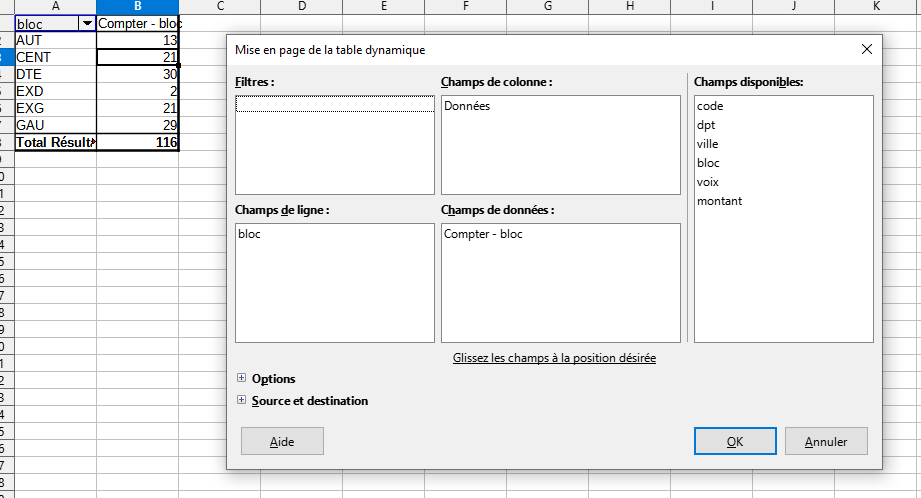
## 13 21 30 2 21 29Sous libre office, on peut utiliser un tableau dynamique pour dénombrer le nombre de blocs sur l’ensemble des villes.
2 Nuage de points
2.1 Quel bloc choisir ?
Pour le 93, quel bloc est lié aux frais de personnel (Y) ?
data <- read.csv("data/baseCours3_93.csv", fileEncoding = "UTF-8", dec =".")
noms <- names(table(data$bloc))
png("img/blocChoix.png", width = 2400, height = 1600, res = 400)
par(mfrow = c(2,3))
for (n in noms){
  tmp <- data [data$bloc==n,]
  plot(tmp$voix, tmp$montant,  xlab = n, ylab = "montant frais", col="coral", pch =  19)
}
dev.off()
## png
## 2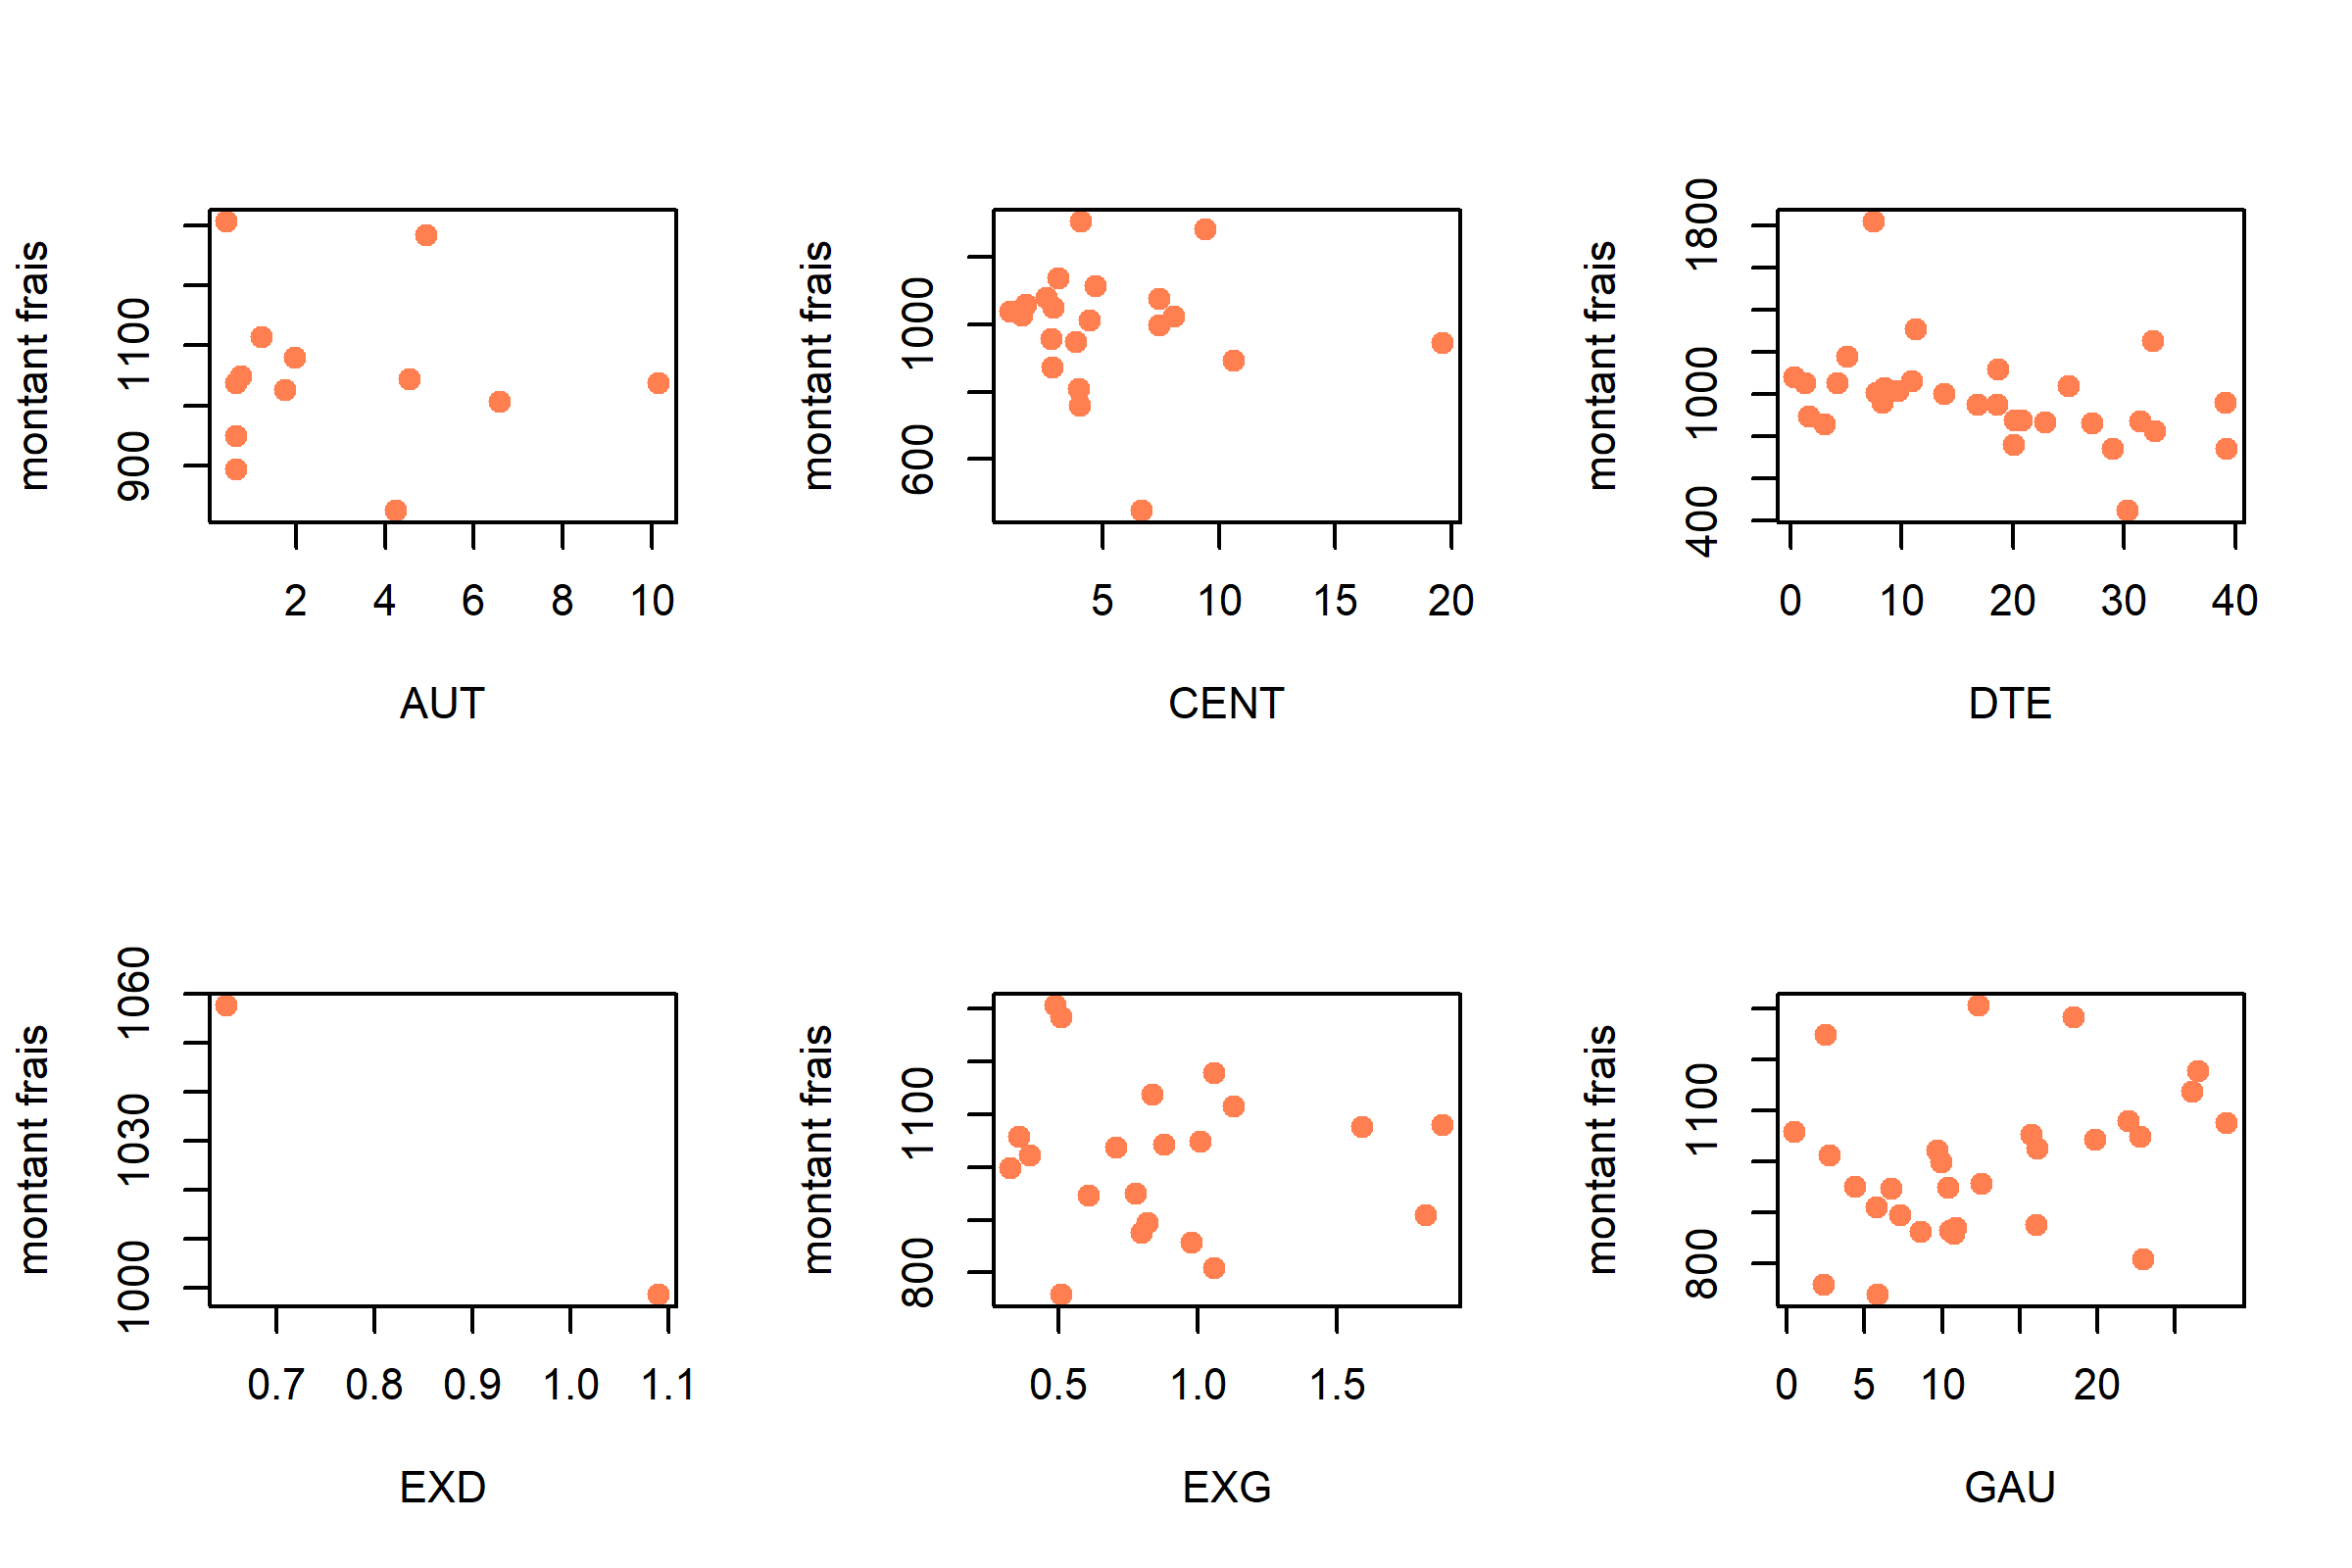
Attention, encore une fois, variable explicative et expliquée.
2.2 Savoirs faire tableur
- graphique XY, attention à la série et aux plages
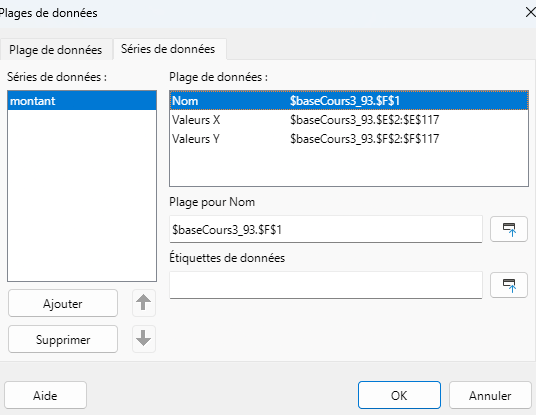
- insertion courbe de tendance linéaire et afficher le R²

2.3 Simplification des chiffres
2.3.1 Redéfinition des bornes
Retour sur les distributions pour enlever les valeurs aberrantes
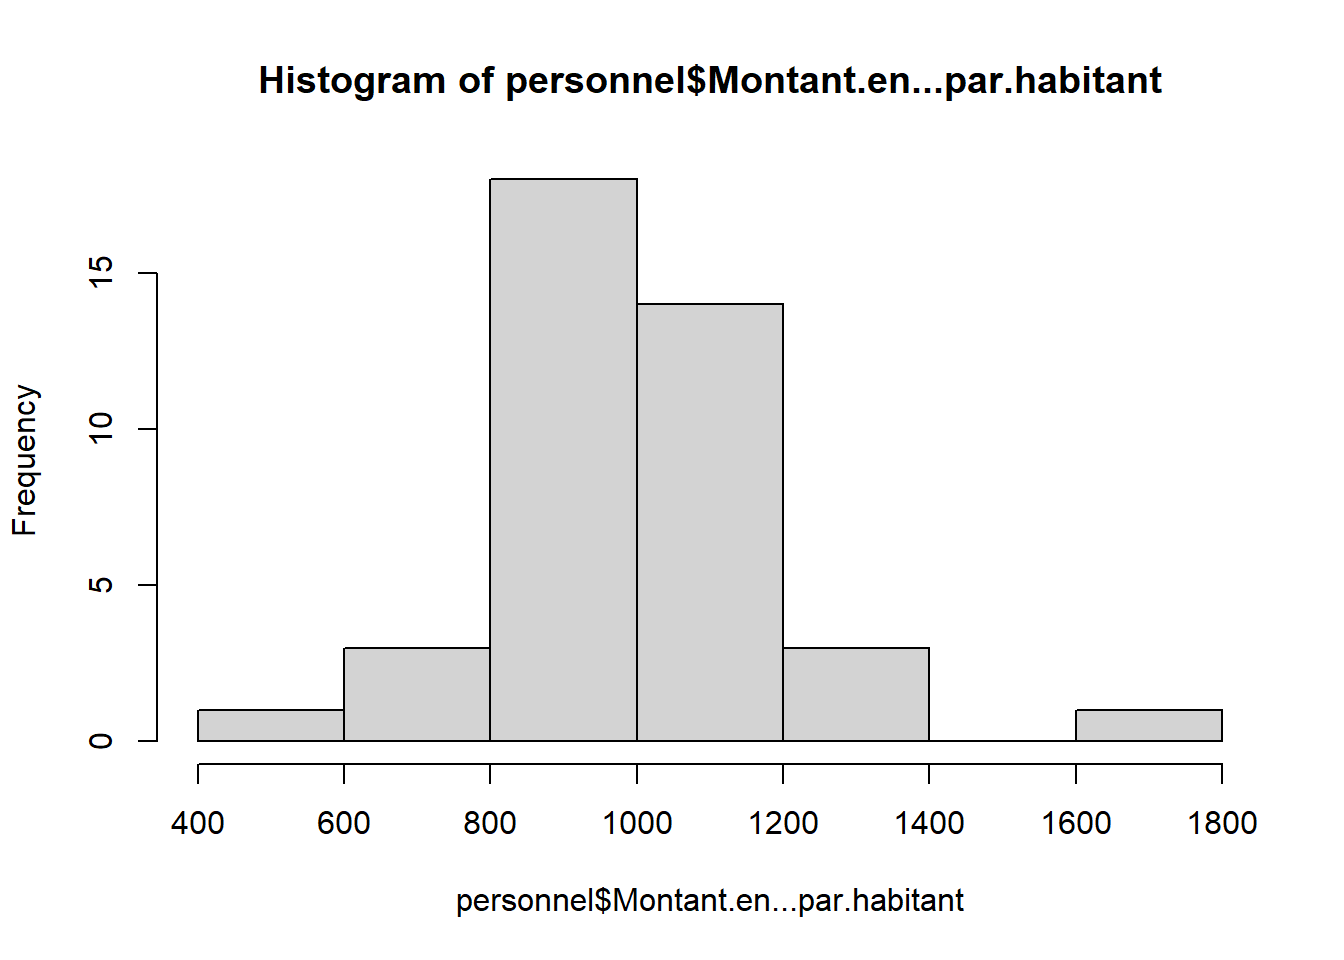
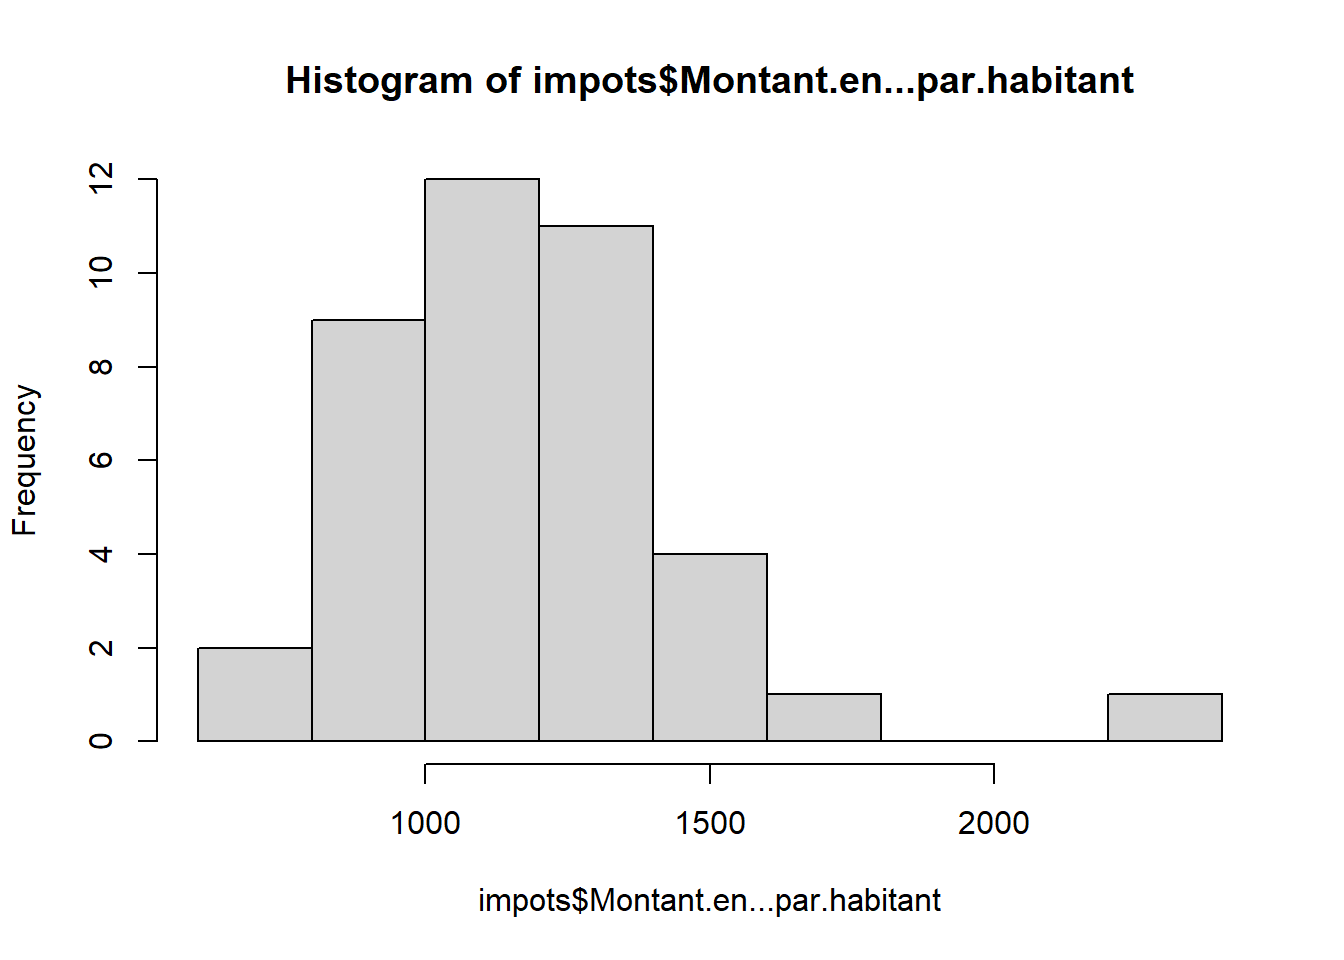
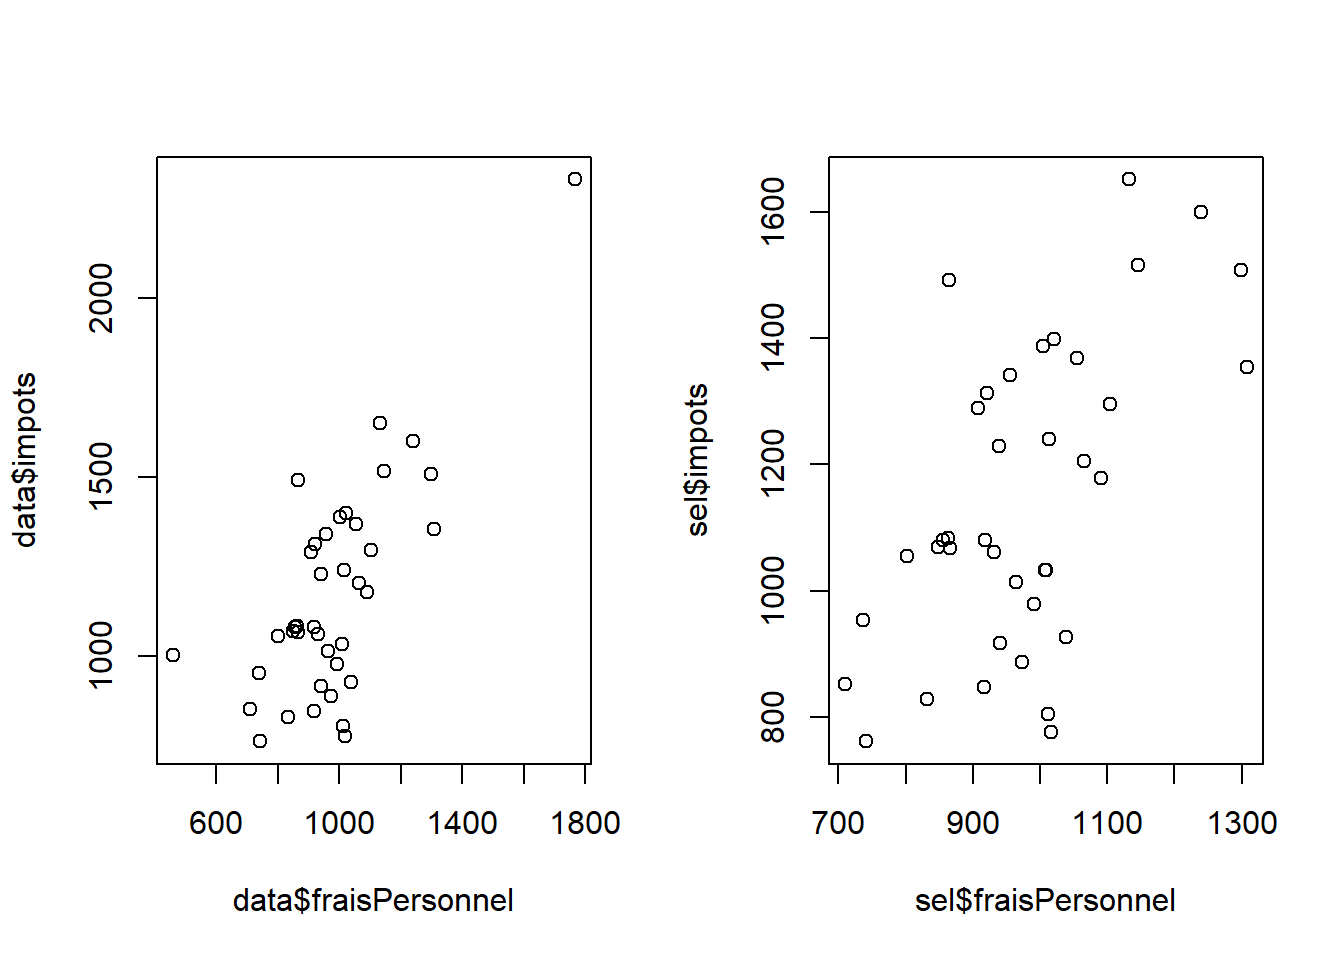
On recherche des bornes permettant d’avoir un nuage de points “cohérent”. Avec le tableur, on fait le graphique puis on ajuste avec le filtre au niveau de la donnée.
Le graphique se met automatiquement à jour
 Observer les variations du R²
3 Droite de régression
3.1 Un peu de mathématiques
La droite de régression minimise la somme des carrés des distances verticales entre chacun des points du nuage et la droite recherchée.
Pour une droite aX+b
a (la pente) = covariance / variance X
b (ordonnée de l’origine) = moyenne de Y - a * moyenne de X
 La distance MP doit être minimale
d’où le terme droite des moindres carrées
3.2 Droite de régression sous R
par(mfrow = c(2,1))
plot(GAU$voix, GAU$montant, pch=20)
# modèle de régression
lm <- lm(GAU$montant~GAU$voix)
abline(lm, lty =2, lwd = 1, col = "red")
text( GAU$voix, GAU$montant,labels = as.character(row.names(GAU))
      , cex=0.6, pos = 2)
# Pour la sélection
plot(sel$voix, sel$montant, pch=20)
# modèle de régression
lm <- lm(sel$montant~sel$voix)
abline(lm, lty =2, lwd = 1, col = "red")
text( sel$voix, sel$montant,labels = as.character(row.names(sel))
      , cex=0.6, pos = 1, pch = 19)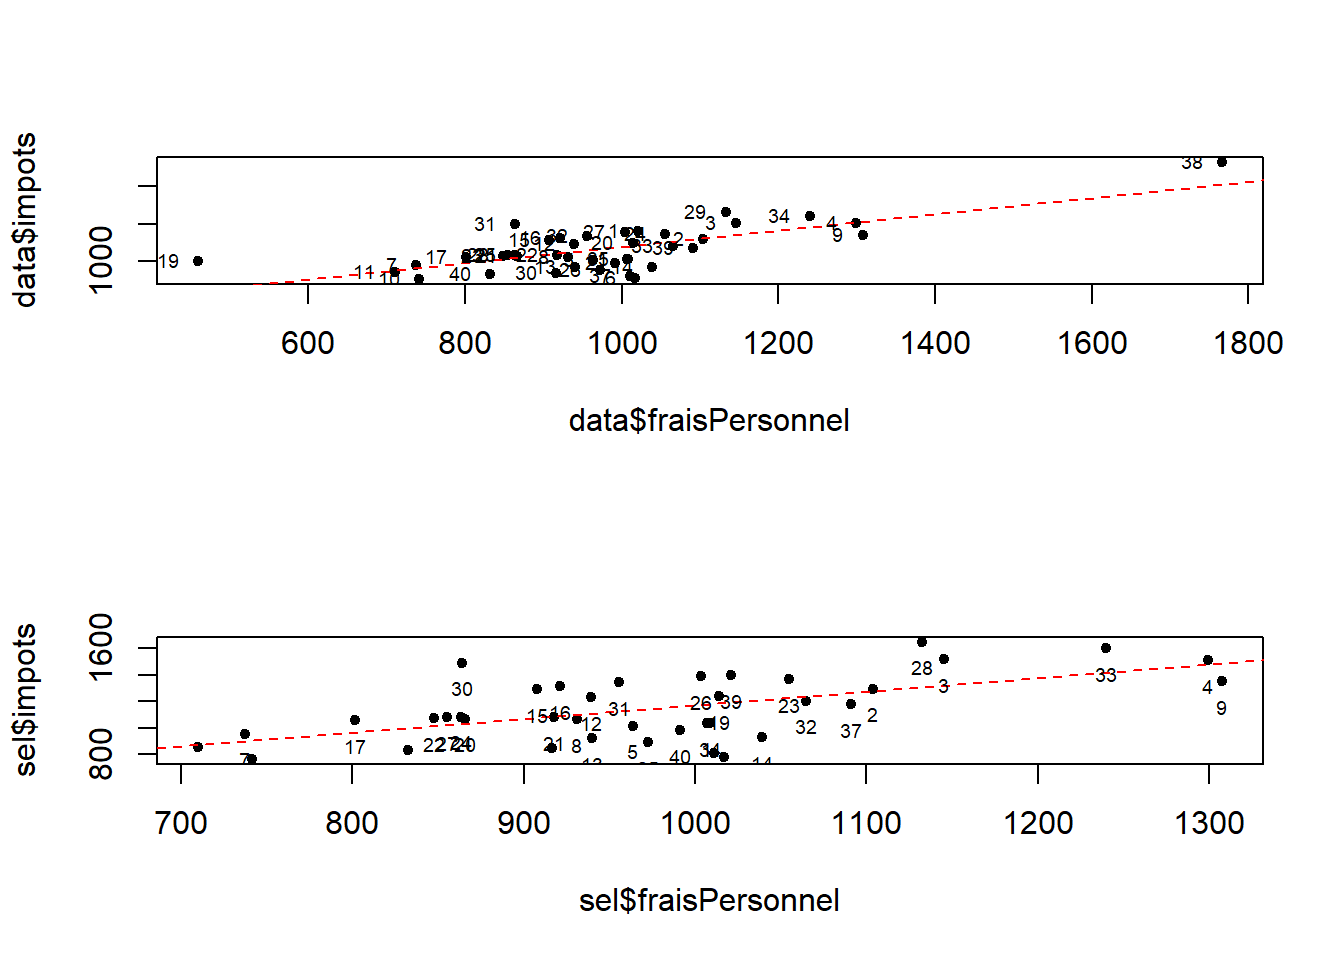
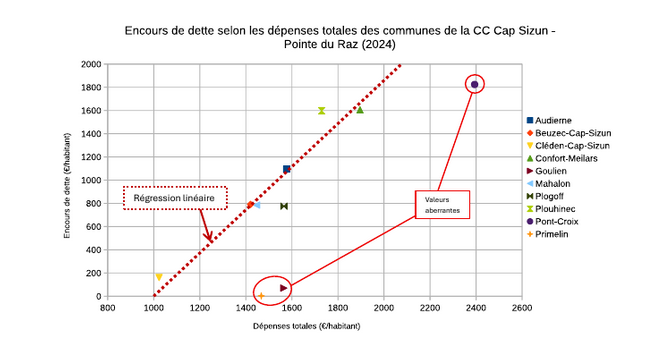
Visuellement, on voit bien qu’il existe un lien entre les deux variables, mais il y a beaucoup de points éparses (les résidus)
Il s’agit maintenant de mesurer précisemment l’intensité du lien à l’aide de calculs (voir après la correction de l’exercice)
4 Correction exercice droite de régression (attention exercice 2025)
4.0.1 Analyse : le message est passé

4.0.2 Vocabulaire
Les variables
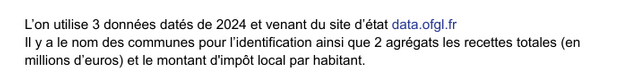
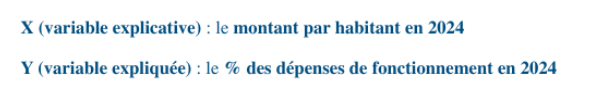 Hypothèse nulle

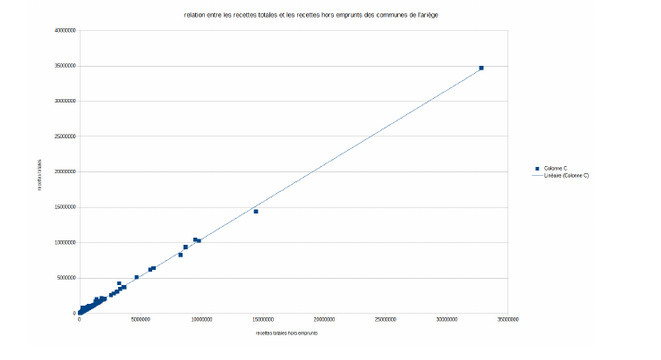
4.1 Le graphique
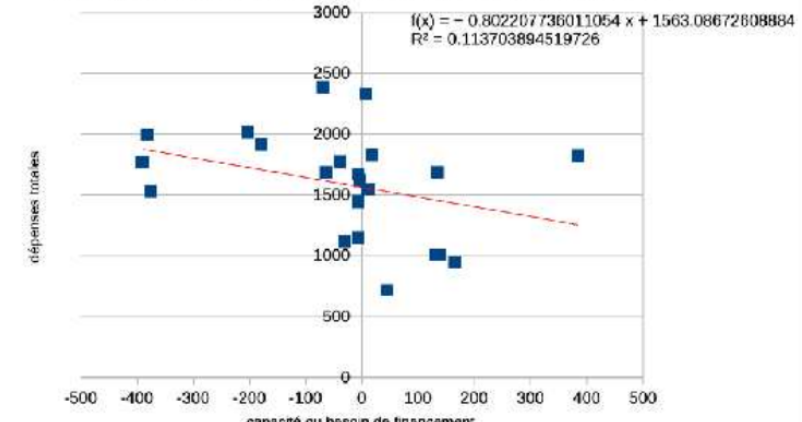
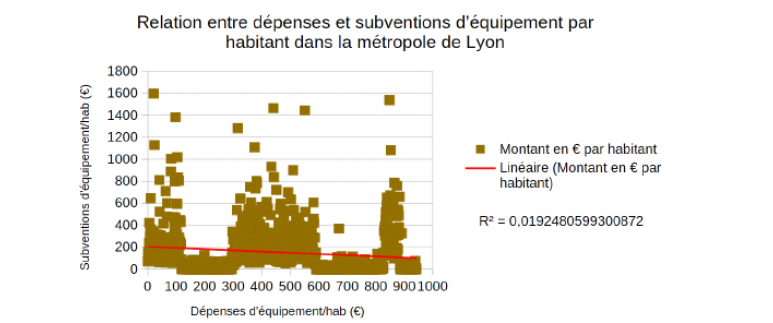
5 Coefficient de correlation
Autrement dit, le coefficient de Bravais-Pearson (1896). Pearson propose une formule mathématique pour la notion de corrélation.
Savoir-faire tableur : utiliser les noms pour les colonnes
5.0.1 Premier temps
On rajoute des colonnes pour chaque variable :
écart à la moyenne
carré ( = distance plutôt que différence)
et pour les deux variables
- produit des écarts (pour étudier le rapport entre 2 variables, techniquement on utilise une division ou une multiplication)
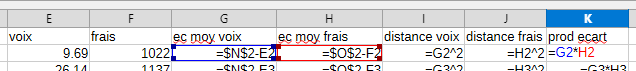
5.0.2 Deuxième temps
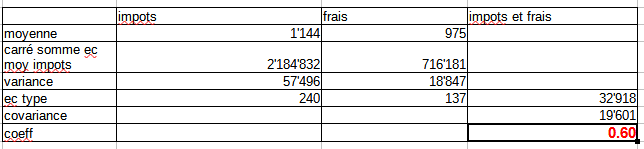
Dans un nouveau tableau, pour chaque variable
moyenne
carré de la somme des écarts à la moyenne
Variance
Ecart type
puis covariance (produit des écarts / nb de valeurs)
et coeff (cov / produit des écarts types)
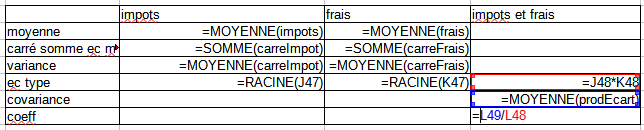
5.0.3 Interprétation
Le coefficient évolue de -1 à +1
Si r = 0, les variables ne sont pas corrélées.
Dans les autres cas, les variables sont corrélées négativement ou positivement.
plus la variable est proche de 1, plus l’intensité de la relation entre les deux variables est forte.
Dans notre exemple, lien assez faible au départ puis plus fort avec la sélection
##               voix    montant
## voix     1.0000000 -0.1837838
## montant -0.1837838 1.0000000## voix montant
## voix 1.0000000 0.5259786
## montant 0.5259786 1.0000000Le coefficient est plus fort si les deux valeurs d’un montant supérieur à 1200 sont supprimées.
6 Coefficient de détermination
Au niveau mathématiques, c’est le carré du coefficient de corrélation linéaire
Mais c’est surtout :
Le rapport entre
- la variation de Y expliquée par le modèle
et
- la variation totale de Y
##              voix   montant
## voix    1.0000000 0.2766535
## montant 0.2766535 1.0000000
Le vote à gauche explique 27 % du montant des frais du personnel dans le meilleur des cas.
Les 73 % restant sont liés à d’autres facteurs.
7 Etude des résidus
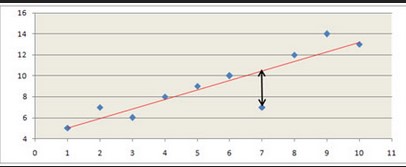
Identifiez graphiquement 2 points isolés de la droite de régression.
Dans notre exemple, ce sont les ville 17, 95 et 34
##       code dpt             ville bloc  voix  montant
## 60   93050  93 Neuilly-sur-Marne  GAU 12.52 955.3081
## NA      NA  NA              <NA> <NA>    NA       NA
## NA.1    NA  NA              <NA> <NA>    NA       NA
A Rosny sous Bois, les frais de personnel sont bas mais les impôt sont élévés. A Clichy sous Bois, les frais de personnel sont élévés mais les impots sont bas.
8 Cartographie des résidus
## Linking to GEOS 3.14.1, GDAL 3.12.1, PROJ 9.7.1; sf_use_s2() is TRUEcommunes <- st_read("data/communes93.geojson", quiet = T)
communes <- communes [!is.na(communes$ref.INSEE), c("name", "ref.INSEE")]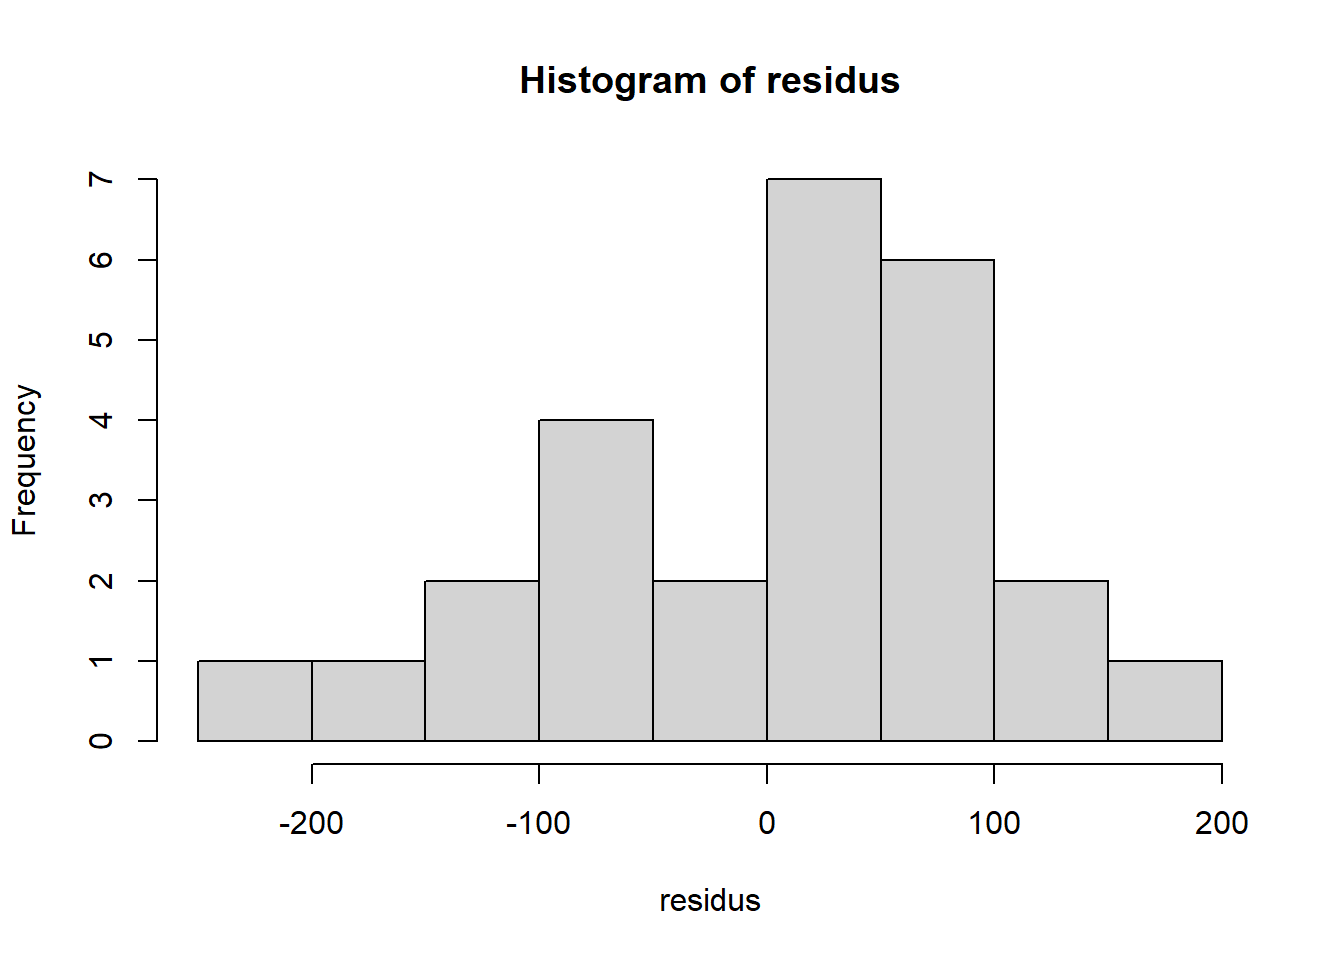
sel <- cbind(sel, residus)
# on calcule les résidus
jointure <- merge(communes, sel, by.x = "name", by.y = "ville")
summary(jointure$residus)
## Min. 1st Qu. Median Mean 3rd Qu. Max.
## -225.981 -69.494 23.508 5.132 63.072 189.054library(mapsf)
png("img/residusCarte.png")
mf_map(jointure, var = "residus", type="choro", breaks = c(-500, -250,0,250,500), pal = cm.colors(4), border = NA, leg_pos = c(2.31589950651953, 48.8793057936166) )
mf_label(communes, var = "name", overlap = FALSE, col= "wheat4", cex = 0.8)
mf_layout("vote de gauche et frais de personnel : étude des résidus", credits = "OFGL 2025, elections municipales 1er tour 2020")## The scale bar cannot be displayed on unprojected (long/lat) maps.## png
## 2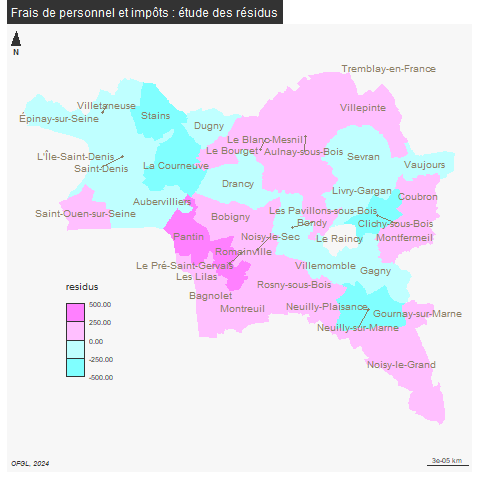
Tremblay et Rosny sous Bois sont écartées, elles représentaient des extrêmes.
Les villes dans les teintes les plus foncées s’éloignent le plus du modèle.
L5GEABIM Analyses bivariées et multivariées